Du prompt à la publication : automatiser un blog Payload avec un agent de codage IA
Un guide pratique pour publier avec Payload CMS grâce à un agent : rédiger l'article, ajouter une image, convertir le Markdown en Lexical, publier en production et vérifier la page en ligne.
Publier un article de blog devrait ressembler à la livraison d'une évolution du produit : l'idée devient un brouillon, le brouillon devient un contenu structuré, le contenu reçoit une image et la page en ligne est vérifiée. Le plus long est rarement de rédiger un paragraphe. Ce sont tous les petits passages de relais autour qui prennent du temps.
Cet article retrace ce cycle. L'objectif était simple : créer un article complet sur l'automatisation de la publication dans Payload CMS avec un agent de codage IA, y joindre une image générée de qualité, le publier sur le blog en production et vérifier que la page finale est visible sur le site.
La tâche
La demande n'exigeait pas une vaste stratégie de contenu. Il fallait un parcours de publication en production bien défini.
Un agent de codage IA peut bien suivre ce parcours lorsque le processus est explicite. Il peut rédiger le Markdown, valider les métadonnées requises en tête de fichier, préparer l'image, exécuter la commande de publication approuvée, examiner le résultat JSON, puis ouvrir l'URL publique pour s'assurer que le travail est réellement visible.
Cette dernière étape compte. Un fichier généré qui reste dans un dépôt n'est pas un article publié. Une ligne de base de données sans image n'est pas l'expérience aboutie. Une commande réussie sans vérification de la page en ligne ne représente encore que la moitié du travail.
Le cycle d'automatisation
Le cycle de publication comportait cinq étapes.
D'abord, l'agent a produit un article Markdown avec un slug stable, une date de publication, un extrait, une liste de catégories, un titre SEO et une description SEO. Le Markdown convient à la rédaction parce qu'il est lisible, facile à comparer et rapide à modifier.
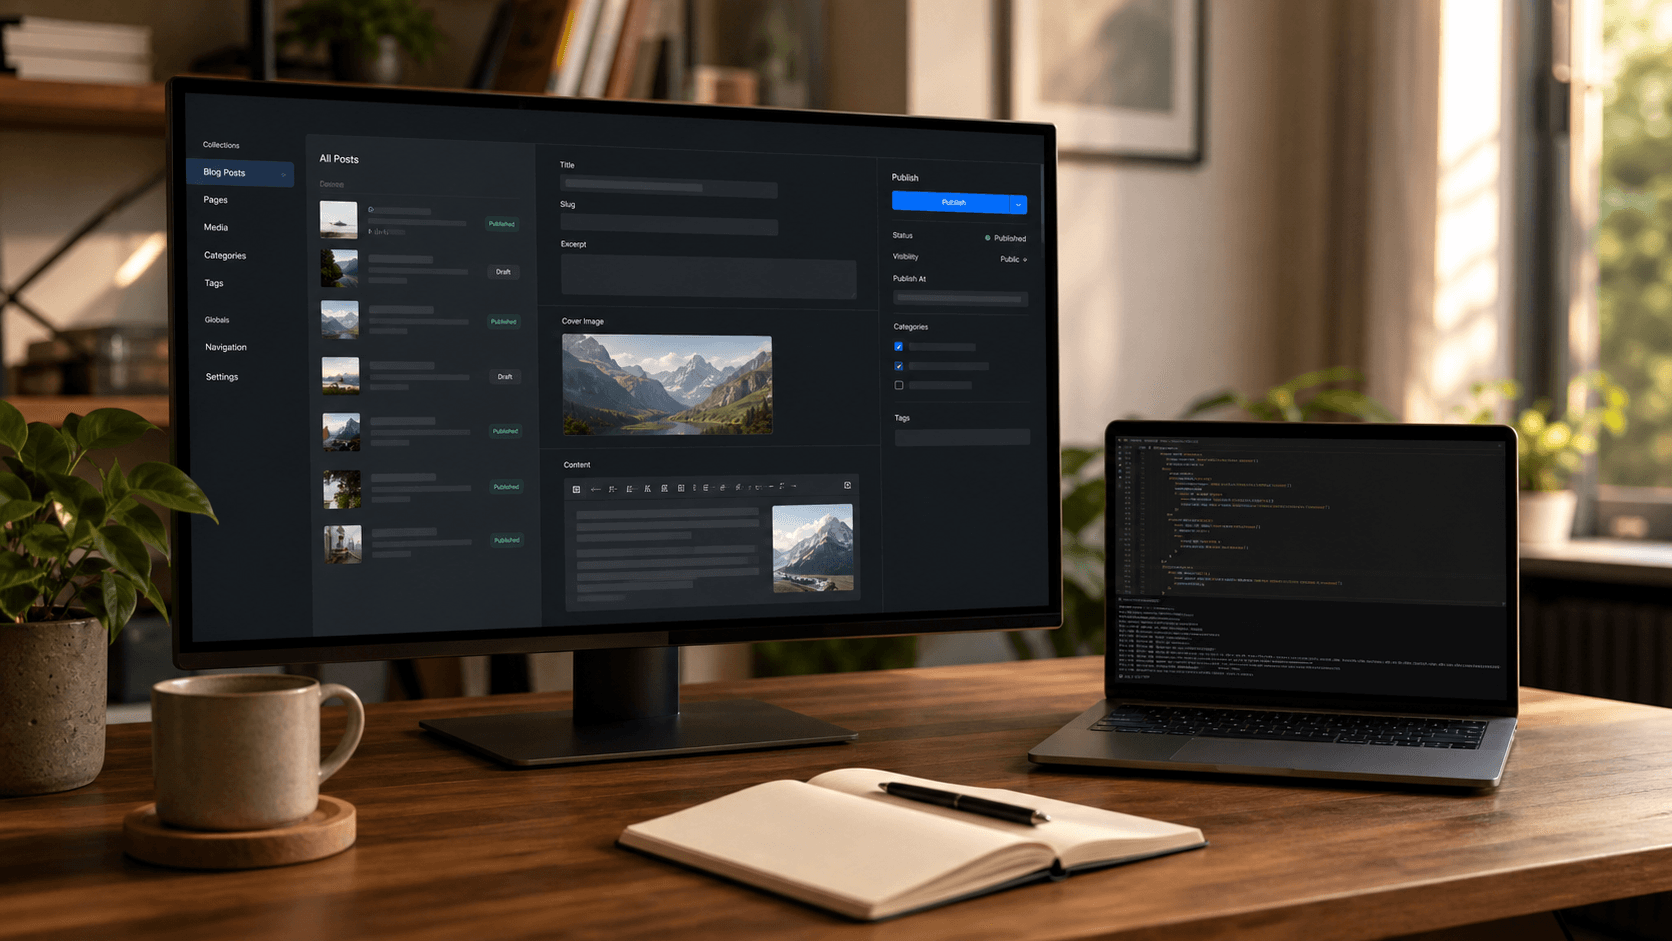
Ensuite, l'agent a préparé une image matricielle plutôt qu'un SVG. Pour un blog consacré à l'automatisation, l'image devait évoquer une photographie éditoriale : un espace de travail soigné, du code et la structure du CMS à l'écran, avec assez de texture visuelle pour donner à l'article une apparence conçue, et pas seulement générée.
Puis le Markdown a été converti dans le modèle de document en texte enrichi de Payload. Payload stocke les articles sous forme de données Lexical structurées ; le script de publication fait donc le lien entre un brouillon facile à lire et le format CMS exact attendu par le site.
Après cela, le contenu a été écrit au moyen de la commande de publication en production approuvée. Le processus reste ainsi précis et vérifiable : aucune modification manuelle de la base de données, aucun clic improvisé dans l'interface d'administration et aucun autre chemin d'écriture que les futurs responsables devraient décortiquer.
Enfin, la page du blog en ligne a été vérifiée après la publication. La vérification fait partie de la publication ; ce n'est pas un supplément facultatif à la fin.
Pourquoi Payload convient bien ici
Payload se prête bien à la publication par agent parce que son modèle de contenu est explicite. Un article a un titre, un slug, un extrait, un statut, une langue, un auteur, des catégories, des liens vers des images et des champs SEO. L'agent peut raisonner sur ces champs avant d'écrire quoi que ce soit.
Cette structure transforme une consigne vague en opération reproductible. Au lieu de « faire un blog », le travail devient « créer un document d'article valide, y joindre des médias valides, publier avec le statut published et vérifier l'URL ».
Elle crée aussi une limite de sécurité utile. L'agent n'a pas besoin d'inventer la structure de la base de données. Il lit le contrat de la collection existante, fournit les champs que le CMS comprend déjà et laisse Payload appliquer le reste.
Ce que l'agent a réellement fait
L'agent est parti des exigences de publication, puis a rédigé le brouillon du blog en Markdown. Il a créé un slug adapté à la production, gardé l'extrait assez court pour les aperçus et ajouté des catégories qui correspondent à l'objectif de l'article.
Ensuite, il a préparé l'image principale sous forme de fichier matriciel. L'image a été téléversée dans la médiathèque de Payload afin que l'article puisse la référencer directement comme image à la une et image SEO.
Puis il a effectué un essai à blanc. Cet essai est la répétition importante : il prouve que les métadonnées en tête de fichier peuvent être analysées, que le Markdown peut devenir du contenu Lexical et que l'article est structurellement prêt avant toute écriture en production.
Ce n'est qu'après cela que l'agent a publié l'article. Le résultat est une entrée CMS complète, pas seulement un fichier local.
La partie utile
La vraie valeur n'est pas qu'un agent IA puisse écrire un article de blog. Tout le monde peut générer des paragraphes.
Ce qui compte, c'est que l'agent puisse mener toute la chaîne de publication : brouillon, image, conversion respectant le schéma, écriture en production et vérification en ligne. Les opérations de contenu deviennent ainsi plus rapides sans perdre en rigueur. Le processus reste vérifiable parce que le Markdown existe. Il reste maîtrisé parce que la publication passe par une seule commande. Il reste pratique parce que la vérification finale a lieu sur le site, pas en théorie.
Voilà à quoi ressemble une bonne automatisation : assez limitée pour inspirer confiance, assez complète pour faire gagner réellement du temps et assez claire pour qu'un autre ingénieur puisse la relancer.
Au cours de ce processus, l'agent a utilisé la mémoire IA de Sno et des techniques d'automatisation de type Scale pour rendre le processus reproductible, vérifiable et rapide.
Written by Sno AI Team
Contributing writer at Sno.ai, sharing insights about AI, productivity, and knowledge management.
Related Articles
Comments
Comments coming soon. Configure Giscus at giscus.app